[!NOTE]
这份文章主要涉及命题逻辑、谓词逻辑和知识图谱推理,有关因果推理的内容,点击链接因果推理。
一、命题逻辑
1、相关概念与定理
- 命题逻辑是应用一套形式化规则对以符号表示呃描述性陈述进行推理的系统。
- 命题是一个能够确定为真或者假的陈述句,通常使用小写符号$p$或者$q$来表示。命题总有一个“值”,称为真值,为真或者假,只有确定真值的陈述句才是命题,无法判断正确性的描述性句子不能作为命题。
- 原子命题指不包括其他命题或者作为其组成部分的命题,又称为简单命题。复合命题指包含其他命题作为其组成部分的命题。在命题逻辑中,一个或真或假的描述性陈述被称为原子命题,对原子命题的内部结构不做任何解析。若干原子命题可以通过逻辑运算符来构成复合命题。
- 可以通过命题联结词对已有命题进行组合,得到新命题。
- 给定命题$p,q$,如果$p,q$在所有情况下都有同样真假的结果,那么$p,q$在逻辑上等价,称为逻辑等价,使用$p\equiv q$表示。逻辑等价为命题进行形式转换带来了可能,基于这些转换不再需要逐一列出$p$和$q$的真值表来判断两者是否在逻辑上等价,而是可直接根据已有逻辑等价公式来判断$p$和$q$在逻辑上是否等价。
- 推理是按照某种策略从前提出发推出结论的过程,使用$\Rightarrow$表示推理。
范式是把命题公式化归为一种标准的形式。范式最大的作用是可以进行两个命题的等价判定。
- 有限个简单合取式构成的析取式称为析取范式。
- 由有限个简单析取式构成的合取式称为合取范式。
- 析取范式与合取范式统称为范式。
- 假设$\alpha_i(i=1,2,⋯,k)$为简单的合取式,则$\alpha=\alpha_1\vee\alpha_2\vee⋯\vee\alpha_k$为析取范式。
- 假设$\alpha_i(i=1,2,⋯,k)$为简单的析取式,则$\alpha=\alpha_1\wedge\alpha_2\wedge\cdots\wedge\alpha_k$为合取范式。
- 一个析取范式是不成立的,当且仅当它的每个简单合取式都不成立。
- 一个合取范式是成立的,当且仅当它的每个简单析取式都是成立的。
- 任一命题公式都存在着与之等值的析取范式与合取范式。命题公式的析取范式与合取范式都不是唯一的。
2、命题联结词
下面两个表格为五个常用命题联结词和其真值表
| 命题连接符号 | 表示形式 | 意义 |
|---|---|---|
| 与 | $p\wedge q$ | 命题合取 |
| 或 | $p \vee q$ | 命题析取 |
| 非 | $\neg p$ | 命题否定 |
| 条件 | $p \rightarrow q$ | 命题蕴含 |
| 双向条件 | $p\leftrightarrow q$ | 命题双向蕴含 |
| $p$ | $q$ | $\neg p$ | $p \wedge q$ | $p \vee q$ | $p \rightarrow q$ | $p \leftrightarrow q$ |
|---|---|---|---|---|---|---|
| False | False | True | False | False | True | True |
| False | True | True | False | True | True | False |
| True | False | False | False | True | False | False |
| True | True | False | True | True | True | True |
上面的条件与双向条件命题可以这么理解: “如果$p$那么$q(p\to q)$”定义的是一种蕴涵关系(即充分条件)也就是命题$q$包含着命题$p$($p$是$q$的子集)$p$不成立相当于$p$是一个空集,空集可被其他所有集合所包含,因此当$p$不成立时,“如果$p$那么q”永远为真。
3、常见逻辑等价
- $a \land \beta \equiv \beta \land a \quad (\land \text{ 的交换律})$
- $a \vee \beta \equiv \beta \vee a \quad (\vee \text{ 的交换律})$
- $(\alpha \land \beta) \land \gamma \equiv \alpha \land (\beta \land \gamma) \quad (\land\text{ 的结合律})$
- $(\alpha \vee \beta) \vee \gamma \equiv \alpha \vee (\beta \vee \gamma) \quad (\vee\text{ 的结合律})$
- $\neg(\neg\alpha) \equiv \alpha \quad (\text{双重否定})$
- $(\alpha \to \beta) \equiv \neg \alpha \vee \beta \quad (\text{蕴涵消除})$
- $(\alpha \leftrightarrow \beta) \equiv (\alpha \to \beta) \land (\beta \to \alpha) \quad (\text{双向消除})$
- $\neg(\alpha \land \beta) \equiv (\neg \alpha \vee \neg \beta) \quad (\text{De Morgan 定律})$
- $\neg(\alpha \vee \beta) \equiv (\neg\alpha \land \neg\beta) \quad (\text{De Morgan 定律})$
- $(\alpha \land (\beta \vee \gamma)) \equiv ((\alpha \land \beta) \vee (\alpha \land \gamma)) \quad (\land \text{ 对 } \vee \text{ 的分配律})$
- $(\alpha \vee (\beta \land \gamma)) \equiv ((\alpha \vee \beta) \land (\alpha \vee \gamma)) \quad (\vee \text{ 对 } \land \text{ 的分配律})$
- $(\alpha \to \beta) \equiv (\neg\beta \to \neg\alpha) \quad (\text{逆否命题})$
4、推理规则
- 假言推理: $\alpha \rightarrow \beta$, $\alpha \Rightarrow \beta$
- 与消解:$\alpha_1 \land \alpha_2 \land \cdots \land \alpha_n \Rightarrow \alpha_i (1 \leq i \leq n)$
- 与导入:$\alpha_1, \alpha_2, \cdots, \alpha_n \Rightarrow \alpha_1 \land \alpha_2 \land \cdots \land \alpha_n$
- 双重否定:$\neg\neg\alpha\Rightarrow\alpha$
- 单项消解或单项归结:$
\alpha\vee\beta,\neg\beta\Rightarrow\alpha$ - 消解或归结:$\alpha\vee\beta,\neg\beta\vee\gamma\Rightarrow\alpha\vee\gamma$
二、谓词逻辑
1、命题逻辑的局限性
命题逻辑的局限性:在命题逻辑中,每个陈述句是最基本的单位(即原子命题),无法对原子命题进行分解。因此在命题逻辑中,不能表达局部与整体、一般与个别的关系。
例如,对于苏格拉底论断,虽知其正确的,但无法通过命题逻辑来进行推理判断:
$\alpha$:所有的人总是要死的。
$\beta$:苏格拉底是人。
$\gamma$:所以苏格拉底是要死的。
$$ \alpha \land \beta \rightarrow \gamma \text{ (不是命题逻辑的有效推理)} $$
无法在命题逻辑基础上完成这样的推导。
在谓词逻辑中,将原子命题进一步细化,分解出个体、谓词和量词,来表达个体与总体的内在联系和数量关系,这就是谓词逻辑研究内容。
2、相关概念与定理
- 谓词逻辑的三个核心概念:个题、谓词、量词。
- 个体是指所研究领域中可以独立存在的具体或抽象的概念。具体或特定的个体成为个体常量,用于表示个体常量的符号成为常量符号,通常使用小写字母表示。所有个体对应的几何成为个体域。
谓词是用来刻画个体属性或者描述个体之间关系存在性的元素,其值为真或假。
- 包含一个参数的谓词成为一元谓词,表示一元关系。
- 包含多个参数的谓词成为多元谓词,表示个体之间的多元关系。
- 全称量词用符号$\forall$表示,存在量词使用符号$\exists$表示。
全称量词和存在量词统称为量词。当公式中存在多个量词时,若多个量词都是全称量词或者都是存在量词,则量词的位置可以互换若多个量词中既有全称量词又有存在量词,则量词的位置不可以随意互换。
全称量词与存在量词之间的组合:
$$ \begin{gathered}\forall xP(x)\equiv\neg\exists x\neg P(x)\\\forall x\neg P(x)\equiv\neg\exists xP(x)\\\neg\forall xP(x)\equiv\exists x\neg P(x)\\\exists xP(x)\equiv\neg\forall x\neg P(x)\end{gathered} $$
设$A(x, y)$是包含变元$x, y$的谓词公式,则如下关系成立:
$$ \begin{aligned}&(\forall x)(\forall y)A(x,y)\Leftrightarrow(\forall y)(\forall x)A(x,y)&&(\exists y)(\forall x)A(x,y)\Leftrightarrow(\forall x)(\exists y)A(x,y)\\&(\exists x)(\exists y)A(x,y)\Leftrightarrow(\exists y)(\exists x)A(x,y)&&(\exists x)(\forall y)A(x,y)\Leftrightarrow(\forall y)(\exists x)A(x,y)\\&(\forall x)(\forall y)A(x,y)\Rightarrow(\exists y)(\forall x)A(x,y)&&(\forall x)(\exists y)A(x,y)\Rightarrow(\exists y)(\exists x)A(x,y)\\&(\forall x)(\forall y)A(x,y)\Rightarrow(\exists x)(\forall y)A(x,y)&&(\forall y)(\exists x)A(x,y)\Rightarrow(\exists x)(\exists y)A(x,y)\end{aligned} $$
在全称量词或存在量词的约束条件下的变量符号称为约束变元。在约束变元相同的情况下,量词的运算满足分配律:
设$A(x)$和$B(x)$是包含变元$x$的谓词公式,则如下逻辑等价关系成立:
$$ (\forall x)(A(x) \vee B(x)) \equiv (\forall x)A(x) \vee (\forall x)B(x) $$
$$ (\forall x)(A(x) \wedge B(x)) \equiv (\forall x)A(x) \wedge (\forall x)B(x) $$
$$ (\exists x)(A(x) \vee B(x)) \equiv (\exists x)A(x) \vee (\exists x)B(x) $$
$$ (\exists x)(A(x) \wedge B(x)) \equiv (\exists x)A(x) \wedge (\exists x)B(x) $$
不受全称量词或存在两次约束的变量符号称为自由变元。自由变元既可以存在于量词的约束范围之内,也可以存在于量词的约束范围之外。
设$A(x)$是包含变元$x$的公式,$B$是不包含变元$x$的谓词公式,则如下逻辑等价关系成立:
$$ (\forall x)(A(x)\lor B)\equiv(\forall x)A(x)\lor B $$
$$ (\forall x)(A(x)\land B)\equiv(\forall x)A(x)\land B $$
$$ (\exists x)(A(x)\lor B)\equiv(\exists x)A(x)\lor B $$
$$ (\exists x)(A(x)\land B)\equiv(\exists x)A(x)\land B $$
项是描述对象的逻辑表达式,被递归地定义为:
- 常量符号和变量符号是项。
- 若$f(x_1,x_2,\cdots,x_n)$是$n$元函数符号,$t_1,t_2,\cdots,t_n$是项,则$f(t_1,t_2,⋯,t_n)$是项。
- 有限次数地使用上述规则产生的符号串是项。
- 若$P(x_1,x_2,\cdots,x_n)$是$n$元谓词,$t_1,t_2,\cdots,t_n$是项,则称$P(t_1,t_2,\cdots,t_n)$是原子谓词公式,简称原子公式。
合式公式是由逻辑联结词和原子公式构成的用于陈述事实的复杂语句,又称谓词公式,由以下规则定义:
- 命题常项、命题变项、原子谓词公式是合式公式。
- 如果$A$是合式公式,则$\neg A$也是合式公式。
- 如果$A$和$B$是合式公式,则$A\wedge B$、$A\vee B$、$A\rightarrow B$、$B\rightarrow A$、$A\leftrightarrow B$都是合式公式。
- 如果$A$是合式公式,$x$是个体变项,则$(\exists x)A(x)$和$(\forall x)A(x)$也是合式公式。
- 有限次数地使用上述规则构成的表达式是合式公式。
3、函数与谓词的区别
函数中个体变元用个体常量代入后结果仍为个体。谓词中个体变元用个体常量带入后就变成了命题。函数是从定义域到值域的映射,谓词是从定义域到$\{\mathrm{True,Flase}\}$的映射。
4、推理规则
设$A(x)$是谓词公式,$x$和$y$是变元,$a,c$是常量符号,则存在如下谓词逻辑中的推理规则:
- 全称量词消去: $(\forall x)A(x) \rightarrow A(y)$
- 全称量词引入:$A(y) \rightarrow (\forall x)A(x)$
- 存在量词消去:$(\exists x)A(x) \rightarrow A(c)$
- 存在量词引入:$A(a) \rightarrow (\exists x)A(x)$
三、知识图谱推理
1、相关概念与定理
- 知识图谱可视为包含多种关系的图。在图中,每个节点是一个实体(如人名、地名、事件和活动等),任意两个节点之间的边表示这两个节点之间存在的关系。
- 知识图谱中存在连线的两个实体可表达为形如
<left_node, relation, right_node>的三元组形式,这种三元组也可以表示为一阶逻辑的形式,从而为基于知识图谱的推理创造了条件。 对实体之间存在的关系进行推理,能够人现有知识中发现新的知识,在实体间建立新关联,从而扩充和丰富现有知识库。
例如从
<奥巴马、出生地、夏威夷>和<夏威夷,属于,美国>两个三元组,可推理得到<奥巴马,国籍,美国>。可利用一节谓词来表达刻画知识图谱中节点之间存在的关系。
例如
<James,Couple,David>的关系可以表示为Couple(James,David)。- 归纳逻辑程序设计(ILP)是机器学习和逻辑程序设计交叉领域的研究内容。
- ILP使用一阶谓词逻辑进行知识表示,通过修改和扩充逻辑表达式对现有知识归纳,完成推理任务。
作为ILP的代表性方法,FOIL通过序贯覆盖实现规则推理。推理思路使从一般到特殊,逐步给目标谓词添加前提约束谓词,直到所构成的推理规则不覆盖任何反例。
从一般到特殊是指对目标谓词或前提约束谓词中的变量赋予具体值,如将
$$ (\forall x)(\forall y)(\forall z)(Mother(z,y)\land Couple(x,z)\rightarrow Father(x,y)) $$
这一推理规则所包含的目标谓词$Father(x,y$)中$x$和$y$分别赋值为$David$和$Ann$,进而进行推理。
2、FOIL算法学习过程
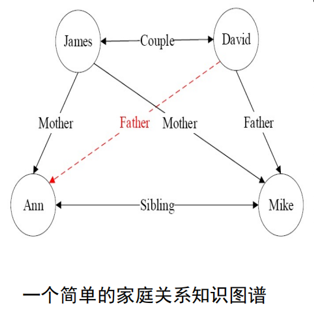
- 给定目标谓词,如:$Father(x, y)$
构造背景知识样例样例 和目标谓词训练样例
- 背景知识:知识图谱中目标谓词以外的其他谓词实例化结果(已知谓词)。
- 目标谓词只有一个正例
Father(David, Mike)。 - 反例:只能在已知两个实体的关系且确定其关系与目标谓词相悖时,才能将这两个实体用于构建目标谓词的反例,而不能在不知两个实体是否满足目标谓词前提下将它们来构造目标谓词的反例。
依次将谓词加入到推理规则中作为前提约束谓词,计算推理规则覆盖的正例和反例:
将
Monther(z, y)作为前提约束谓词加入,可得到推理规则Monther(z, y) → Father(x, y)。在背景知识中,
Monther(z, y)有两个实例:Monther(James, Mike)和Monther(James, Ann)。对于
Monther(James, Mike)这一实例,z=James, y=MIke,将z和y带入Father(x, y)得到Father(x, Mike)。
覆盖了正例Father(David, Mike)和反例Father(James, Mike)Father(Ann, Mike)对于
Monther(James, Ann)这一实例,z=James, y=Ann,将z和y带入Father(x, y)得到Father(x, Ann),覆盖了反例Father(James, Ann)。计算信息增益值,FOIL信息增益值计算方法如下:
$$ FOIL\_Gain=\widehat{m_{+}}\cdot\left(\log_{2}\frac{\widehat{m_{+}}}{\widehat{m_{+}}+\widehat{m_{-}}}-\log_{2}\frac{m_{+}}{m_{+}+m_{-}}\right) $$
其中,$\widehat{m}_{\pm}$和$\widehat{m}_{-}$是增加前提约束谓词后所得新推理规则覆盖的正例和反例的数量,$m_+$和$m_-$是原推理规则所覆盖的正例和反例数量。
- 基于计算所得FOIL增益值来选择最佳前提约束谓词。
- 建立新的推理规则以及更新训练样本集。
- 重复上面的步骤,直至新规则不覆盖任何反例。